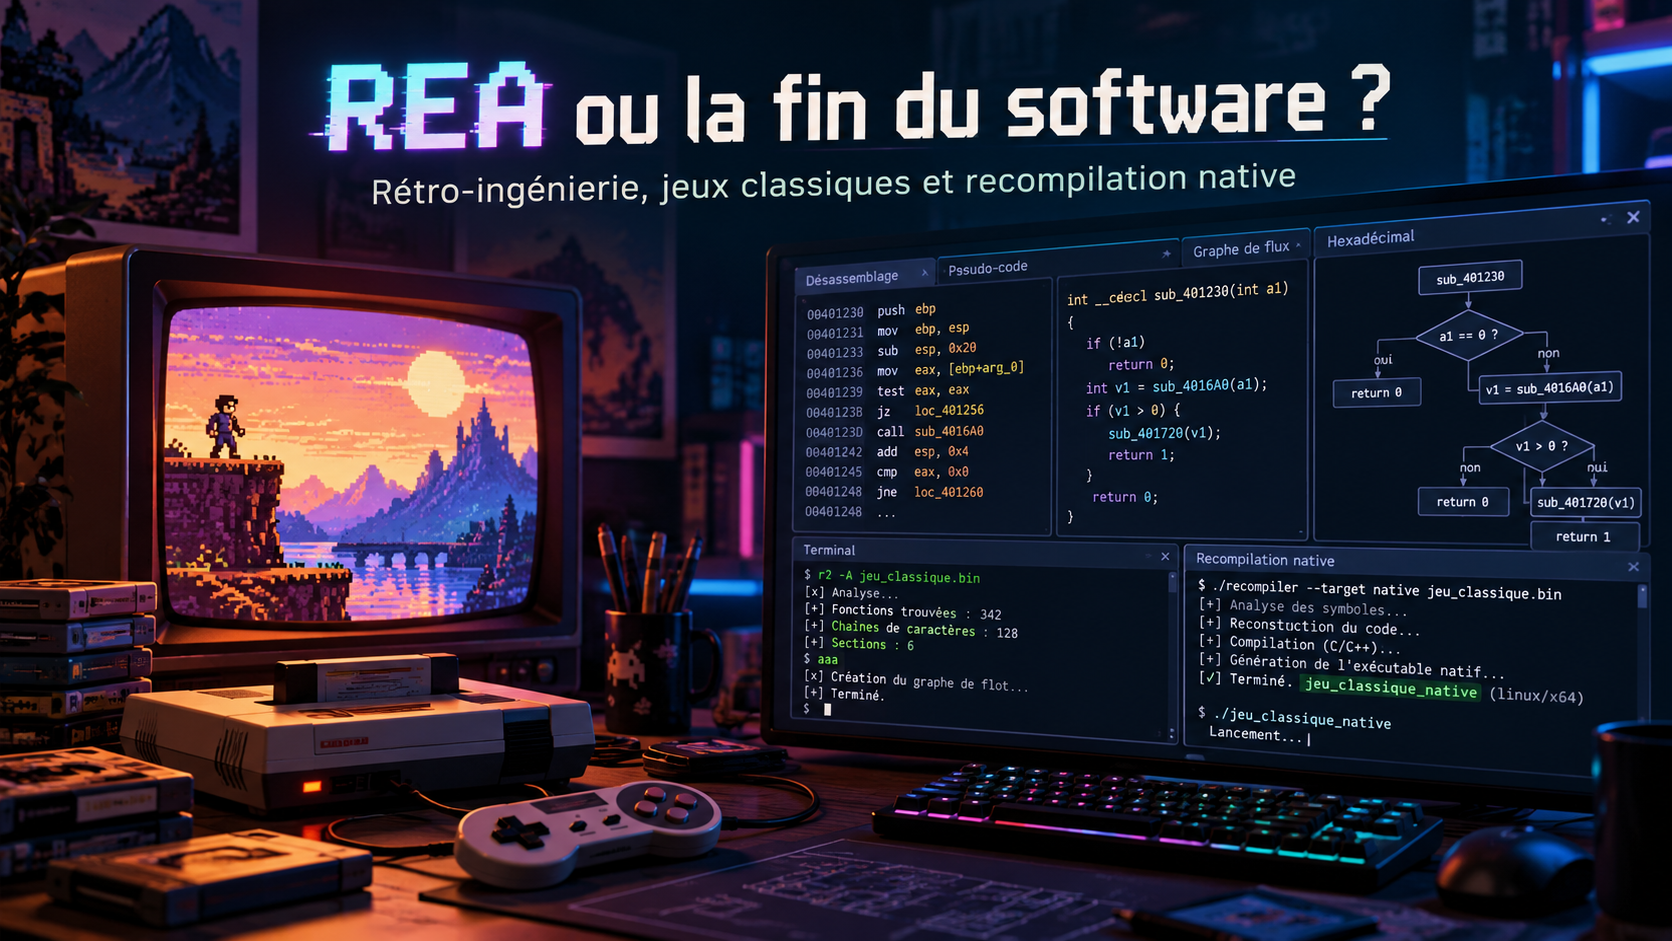
01 Un soir d’octobre, je donne un EXE à Codex
Comme beaucoup, j’ai découvert REA dans mes fils d’actualité. J’ai regardé quelques vidéos de présentation sur YouTube, avec le niveau de scepticisme habituel du développeur qui a déjà vu passer plusieurs révolutions capables de tout faire, sauf de fonctionner sur son propre projet. Pendant une de ces longues soirées d’octobre, j’ai finalement demandé à Codex d’installer les outils nécessaires et de préparer REA.
Mes premières demandes étaient modestes : « Comment fonctionne ce bouton ? », « À quoi correspond le libellé en bas à droite ? » Je voulais surtout voir si le système pouvait réellement analyser une application ou s’il allait me produire une explication très convaincante de quelque chose qu’il n’avait pas compris. Puis j’ai lancé, presque par provocation : « Tu peux me refaire l’application à fonctionnalités équivalentes et la recompiler dans le langage que tu veux ? »
Plus de cinq heures plus tard, il m’annonce une première version, avec des éléments encore à terminer et un exécutable à essayer. Je le lance. Visuellement, dans les parcours que je teste, j’ai l’impression d’être revenu dans l’application d’origine. Je ne parle pas d’une simple description ou d’une maquette : j’ai devant moi un programme qui s’exécute. Je suis franchement abasourdi.
J’ai poursuivi sur un autre projet, plus difficile à analyser et davantage protégé. Là encore, les résultats m’ont surpris. Je ne vais ni identifier ce logiciel ni détailler ses protections : l’intérêt de cet article est ailleurs. Ma réaction immédiate a été excessive, mais très sincère : « Le logiciel client lourd est mort. Les logiciels compilés sont maintenant open source. » Avec un peu de recul, je formulerais cela autrement. Ce qui vacille, c’est surtout l’idée qu’un exécutable livré sans ses sources constitue une boîte noire durablement inaccessible.
02 REA expliqué avec un jouet dont on a perdu la notice
Imagine un petit train construit avec des briques. Tu as le train, mais plus la notice. Tu peux regarder comment les roues tournent, sur quel bouton on appuie pour allumer la lumière et comment les pièces semblent reliées. Quelqu’un de suffisamment patient peut alors écrire une nouvelle notice pour construire un train qui se comporte de façon comparable. Ce ne sera pas nécessairement la notice originale, ni exactement la même organisation des pièces.
Pour un logiciel, l’idée est proche. L’exécutable est le train déjà construit. Les outils de rétro-ingénierie permettent d’en examiner les mécanismes. REA donne à un agent IA un accès organisé à ces outils. L’agent rassemble les indices, propose une explication, puis peut écrire une nouvelle implémentation et la tester. La compilation transforme ensuite cette nouvelle implémentation en programme utilisable sur la machine cible. [1][2]
Une explication simplifiée : la nouvelle notice n’est pas forcément la notice d’origine.
Le détail important, même dans cette explication pour enfant, est le suivant : on ne retrouve pas automatiquement la notice perdue. On cherche à comprendre assez précisément le fonctionnement pour en reconstruire une. Les commentaires du développeur, les noms de variables supprimés et certaines intentions de conception ne réapparaissent pas simplement parce qu’une IA est impliquée.
03 Sous le capot : REA ne travaille pas tout seul
REA signifie Reverse Engineer Anything. Le projet fournit notamment un serveur MCP et une interface en ligne de commande. Il relie les agents à des outils d’analyse existants ; ce n’est pas un décompilateur universel apparu de nulle part. Pour les binaires natifs, il peut s’appuyer sur des moteurs comme Ghidra, Hopper ou IDA, selon la configuration et les capacités disponibles. Ghidra, par exemple, fournit déjà du désassemblage, de la décompilation et des graphes d’analyse. [1][3]
Le MCP, ou Model Context Protocol, sert ici d’interface entre l’agent et les outils. Au lieu de me demander de copier manuellement des pages de résultats, l’agent peut appeler une fonction d’analyse et recevoir sa réponse. Codex sait se connecter à des serveurs MCP ; REA lui donne ainsi accès à un environnement d’investigation, pas à une connaissance magique de tous les logiciels. [4][5]
| Brique | Son rôle |
|---|---|
| L’agent, ici Codex | Organiser l’enquête, formuler des hypothèses et écrire la reconstruction. |
| REA | Exposer des outils et restituer les observations, avec leurs limites. |
| Ghidra, Hopper ou IDA | Examiner le binaire : instructions, fonctions, références et pseudo-code. |
| Le compilateur | Produire un nouveau programme pour la plateforme choisie. |
| Les tests | Vérifier ce que la reconstruction fait réellement. |
Une investigation peut partir d’une chaîne de caractères affichée à l’écran, rechercher les fonctions qui la référencent, suivre leurs appels puis comparer le résultat à ce que l’application fait lorsqu’on clique. REA documente ce type d’analyse ciblée. Mais une relation observée dans le code ne prouve pas, à elle seule, qu’un scénario a réellement été exécuté : il faut distinguer l’analyse statique des observations à l’exécution. [2]
Le résultat est donc une boucle : observer, comprendre, implémenter, compiler, exécuter, comparer, corriger. C’est le rapprochement de ces étapes qui m’impressionne. La rétro-ingénierie existait bien avant les agents IA ; ce qui change dans mon quotidien, c’est la vitesse à laquelle je peux passer d’une question sur un binaire à une version modifiable.
Pour démarrer, la documentation officielle propose notamment npx rea-agents setup. L’assistant présente les intégrations et les changements avant validation. Cela ne dispense ni d’installer un moteur adapté ni de respecter sa licence. Et pour reproduire une expérience, mieux vaut noter la version de REA, le moteur d’analyse et le modèle utilisés plutôt que de conserver uniquement le prompt. [6]
04 Pourquoi j’insiste sur le mot « nativement »
Je ne cherchais pas seulement à faire démarrer un vieux jeu. Je voulais obtenir un programme construit pour ma machine actuelle. Ce n’est pas le même objectif que lancer l’exécutable d’époque dans un environnement compatible ou dans un émulateur.
| Approche | Ce que l’on cherche à obtenir |
|---|---|
| Compatibilité | Faire fonctionner le programme d’origine en adaptant son environnement. |
| Émulation | Reproduire le comportement d’une autre machine ou de certains de ses composants. |
| Reconstruction et portage natif | Produire une implémentation compilée pour la plateforme visée. |
Cela ne rend pas l’émulation inférieure. Elle reste une solution formidable, et mes essais précédents avec des couches de compatibilité m’ont aussi rendu service. Mon envie était simplement différente : pouvoir intervenir sur le programme lui-même, modifier son affichage, son entrée manette ou son fonctionnement réseau.
Précision technique : écrire « NATIVEMENT » dans un prompt ne force pas mathématiquement une réécriture complète. C’est une exigence de résultat. Une chaîne peut mêler code reconstruit, bibliothèques de compatibilité ou traduction de portions du programme. Il faut donc regarder ce qui a été construit et ce qui tourne réellement, pas seulement faire confiance au mot employé par l’agent. Compiler pour une autre cible suppose aussi d’adapter les bibliothèques et l’environnement de compilation. [8]
Faire fonctionner l’ancien programme
Binaire d’origine
↓
Environnement compatible ou machine émulée
↓
Comportement ancien dans un environnement adapté
Construire une version pour la cible
Observations + implémentation reconstruite
↓
Compilation adaptée à chaque plateforme
↓
Windows x64 / Linux ARM64 / macOS ARM64
Une architecture CPU commune ne suffit pas : le système, les bibliothèques et les tests restent propres à chaque cible.
05 Cluedo : retour sur le Pentium III de ma grand-mère
Moi aussi, je vieillis. Il y a des jeux auxquels j’ai envie de rejouer non pas parce qu’ils auraient les meilleurs graphismes du marché, mais parce qu’ils me ramènent immédiatement à une époque. Cluedo, dans sa version de 1998, fait partie de ceux-là. Je me revois sur le Pentium III de ma grand-mère, dans les années 2000, à passer un temps parfaitement raisonnable à chercher le coupable. Enfin, raisonnable selon mes critères.
Je me suis donc replongé dans les catalogues de jeux anciens souvent regroupés sous le terme « abandonware ». Le mot est pratique pour retrouver une époque ; il ne constitue pas une autorisation juridique de télécharger ou de redistribuer tout ce que l’on y trouve. J’y reviens plus loin, car c’est un point important de cette histoire. [12][14]
Dans la copie de Cluedo que j’ai étudiée, mon diagnostic faisait intervenir un programme 32 bits et un composant ancien en 16 bits. Je distingue ici ce que j’ai identifié dans mon exemplaire d’une affirmation sur toutes les éditions du jeu. Le problème général, lui, est documenté : Windows x64 ne fournit pas NTVDM pour exécuter les anciennes applications Windows 16 bits. Un jeu peut donc avoir une partie principale 32 bits et rester bloqué par un composant périphérique plus ancien. [7]
Ma demande à Codex était claire : obtenir une version native pour un Windows moderne en x64, en s’appuyant sur les outils REA. J’ai utilisé un effort de raisonnement élevé. Après plusieurs heures et les itérations nécessaires, j’avais une version jouable. Le résultat m’a d’autant plus marqué que mon point de départ n’était pas le dépôt source du jeu, mais ses fichiers distribués.
06 Tant qu’à faire : du 16/9, puis mon Raspberry Pi
Une fois le jeu fonctionnel, j’ai immédiatement retrouvé un problème très contemporain : je n’ai plus d’écran 4/3 à la maison. J’ai donc demandé une adaptation de l’interface en 16/9. Je ne voulais pas seulement étirer l’image et transformer tous les personnages en versions légèrement écrasées d’eux-mêmes ; je voulais que l’affichage s’adapte proprement au nouvel écran.
Ce type de changement oblige à penser à la disposition des éléments, aux coordonnées de clic et aux proportions des ressources. Une image peut paraître correcte tout en laissant une zone interactive à son ancienne position. Ce sont donc plusieurs comportements à tester, pas simplement une résolution à remplacer dans un fichier.
Puis j’ai poussé le vice : « Maintenant, je veux que cela fonctionne nativement sur mon Raspberry Pi 4 en ARM64. » Et j’ai obtenu une version que j’ai pu utiliser sur le Pi. Revoir ce jeu tourner sur cette petite machine, après l’avoir connu sur le PC de ma grand-mère, m’a fait un drôle d’effet.
J’ai ensuite joué plusieurs parties sans rencontrer de bug. Je conserve cette formulation volontairement : ne pas rencontrer de bug pendant mes parties n’est pas démontrer qu’il n’en existe aucun. En revanche, pour mon usage et les parcours essayés, je n’étais plus face à une simple démonstration de menu. Je pouvais jouer.
07 Daytona USA Deluxe : écran large et manette Xbox
Après Cluedo, j’ai continué avec Daytona USA Deluxe, dans sa version PC de 1997. L’objectif restait le même : retrouver le jeu sur mon Raspberry Pi, lui donner un affichage adapté au 16/9 et éviter de dépendre de toute une installation ancienne pour en profiter.
Une fois cette étape franchie, j’ai ajouté une demande très terre à terre : je voulais utiliser ma manette Xbox moderne. Pas ressortir une manette de Saturn pour le folklore, ni consacrer la soirée à bricoler des touches au clavier. Les émulateurs savent souvent proposer leur propre mapping ; dans mon cas, je voulais intégrer ce support à la version reconstruite. L’adaptation a donc porté sur l’entrée manette de cette version, et j’ai pu jouer avec cette configuration.
C’est là que l’expérience change de nature. Je ne demande plus uniquement de préserver le comportement d’origine : je commence à faire évoluer le programme. Le binaire ancien sert de point de départ à la compréhension ; la version reconstruite devient un projet sur lequel je peux travailler.
Mon choix pour ce type de portage est de privilégier une implémentation C++ et des dépendances maîtrisées. Ce n’est pas une garantie automatique de performance : un mauvais algorithme reste un mauvais algorithme, même compilé en C++. Mais sur un Raspberry Pi, je préfère une architecture dont je comprends le coût plutôt qu’un empilement de couches ajouté uniquement parce que l’agent les a proposées.
08 Destruction Derby : et si on ajoutait du réseau ?
Destruction Derby, sorti en 1995, représente un autre souvenir très fort de ma PlayStation. En 2026, il a déjà dépassé les trente ans. Pour cette troisième expérience, j’ai repris mes objectifs : affichage 16/9, cible ARM64 et manette Xbox. Puis je me suis demandé si je pouvais aller plus loin et jouer avec les autres ordinateurs de la maison.
J’ai donc demandé un mode multijoueur réseau. Dans ma reconstruction, j’ai obtenu une version permettant de jouer en réseau local, avec des versions pour Windows, Mac Apple Silicon et Raspberry Pi ARM64. Je parle bien du résultat de mon projet et de mes essais, pas d’un portage officiel ni d’une compatibilité garantie sur tous les appareils.
Ajouter du multijoueur ne consiste évidemment pas à relier deux boutons « Jouer ». Il faut déterminer quelles informations échanger, qui décide de l’état de la partie et ce qui se passe lorsque les machines ne reçoivent pas une information au même moment. Positions, collisions et synchronisation deviennent des problèmes de développement à part entière. Ces points expliquent le travail à traiter ; je ne prétends pas ici documenter le protocole exact de ma version.
Et petite précision pour les architectures : Mac Apple Silicon et Raspberry Pi peuvent tous deux être ARM64 sans partager le même exécutable. Le système d’exploitation, les bibliothèques et la chaîne de compilation changent. L’intérêt est d’avoir une base de code adaptable à plusieurs cibles, pas un fichier universel qu’on copierait partout. [8]
09 De la magie noire, mais pas un bouton « convertir »
Quand je raconte cela, j’utilise volontiers l’expression « magie noire ». Le contraste entre les fichiers de départ et le résultat est suffisamment violent pour la justifier autour d’un café. Techniquement, il faut tout de même séparer plusieurs choses : analyser le programme, reconstruire son comportement, réutiliser éventuellement certaines ressources et écrire les nouvelles fonctionnalités.
Les graphismes, musiques, vidéos, textes et niveaux ne deviennent pas soudainement du code C++ librement réutilisable. Une reconstruction peut avoir besoin des fichiers de données du jeu d’origine. Sans inventaire de ces ressources, on ne sait pas encore ce qui appartient au nouveau code, ce qui dépend de la copie originale et ce que l’on pourrait éventuellement partager. Le projet REA rappelle lui-même que ses sorties d’analyse ne confèrent pas de droits sur le programme étudié. [14]
Pour évaluer sérieusement un résultat, j’attends davantage qu’un écran qui s’ouvre : une compilation reproductible, les parcours essentiels, des sauvegardes qui se rechargent, les commandes réellement utilisées et des essais sur les machines cibles. La durée d’une session de jeu, les cas non testés et les régressions comptent aussi. Un agent qui annonce « terminé » n’a pas automatiquement terminé le travail de validation.
C’est ce qui rend mes essais intéressants sans les transformer en promesse universelle. Je n’affirme pas qu’une application de vingt ans se réécrit toujours en cinq heures. J’affirme que, sur certains projets que j’ai essayés, l’écart entre l’effort que j’imaginais et le résultat obtenu m’a vraiment surpris.
10 Le logiciel compilé est-il devenu open source ?
Ma première réaction était : « Maintenant, tout est open source. » C’est une bonne phrase de développeur sous le choc, mais une mauvaise définition. L’open source ne désigne pas seulement la possibilité de lire du code : il repose aussi sur une licence accordant des droits d’utilisation, de modification et de redistribution. Reconstituer un programme ne change pas, à lui seul, la licence de l’original. [11]
La vraie rupture que je perçois est économique et technique. Si un comportement peut être compris et reconstruit avec moins de travail humain qu’auparavant, l’éditeur ne peut plus compter de la même façon sur le simple fait de livrer un binaire opaque. Ce n’est pas la fin de sa valeur : le support, la qualité, les mises à jour, les données, les garanties et l’écosystème ne se résument pas au fichier EXE.
Un antivirus illustre bien cette différence : reproduire une partie du client ne recrée pas automatiquement la veille, les mises à jour ni les services qui l’accompagnent. Pour un IDE, comprendre un comportement et supprimer un contrôle de licence sont également deux objectifs différents. Les possibilités d’analyse ne doivent pas être confondues avec un droit de se servir gratuitement de tout un produit. [14]
Cela ne signifie pas non plus que tout code protégé devient immédiatement lisible. Selon les composants, le chiffrement, l’obfuscation, les dépendances ou ce qui est réellement disponible, l’analyse peut rester partielle. REA décrit explicitement les limites de ses observations ; l’agent ne devrait pas remplacer une information absente par une certitude bien rédigée. [2][14]
Pour moi, le client lourd n’est donc pas mort. Il pourrait même retrouver une deuxième vie : davantage portable, réparable et adaptable lorsque le cadre technique et juridique le permet. Ce qui prend un coup, c’est la fatalité du « nous n’avons plus les sources, donc nous ne pouvons plus rien faire ».
11 Chrome sur un CPC464 et les promesses autour de la PS2
À ce stade, le cerveau commence forcément à déraper : « Et si je demandais un Chrome moderne pour mon Amstrad CPC464 ? Je soude un peu de mémoire et c’est réglé. » 😄 La plaisanterie résume assez bien l’euphorie du moment. Mais ajouter de la RAM ne transforme pas cette machine en ordinateur contemporain : on parlerait d’une adaptation radicale, d’un démake ou d’un affichage déporté, pas du même navigateur complet transféré sans compromis.
Même prudence pour la PlayStation 2. Le fait qu’un outil sache analyser certaines instructions ou certains binaires ne signifie pas qu’il sait reconstruire automatiquement n’importe quel jeu pour ARM64. Le moteur d’analyse, les formats, les composants propres à la plateforme et les tests restent déterminants. Dans la documentation publique consultée pour cet article, je n’ai pas identifié de garantie générale de portage natif PS2 ; je ne vais donc pas annoncer qu’elle sera disponible « le temps que l’article sorte ». [1][15]
Cela ne retire rien à l’intérêt de la piste. Cela évite simplement de transformer mon enthousiasme pour une technologie qui avance vite en calendrier de livraison inventé.
12 Avec le SaaS, il manque une partie du puzzle
Tout ce que je viens de raconter part d’un avantage important : une partie substantielle du programme est présente dans les fichiers dont je dispose. Pour une application SaaS, le navigateur ne reçoit pas nécessairement le moteur métier. Il reçoit ce qui est nécessaire pour afficher les pages et communiquer avec le serveur.
REA documente l’observation de pages, de scripts et d’échanges réseau accessibles dans un environnement autorisé. Ces indices peuvent aider à comprendre des écrans, des paramètres ou certains comportements. Ils ne révèlent pas automatiquement le code du serveur. Observer une réponse d’API, ce n’est pas récupérer la fonction qui l’a produite. [9][10]
Côté client : observable dans le cadre autorisé
Interface et scripts reçus
Requêtes envoyées et réponses reçues
Côté serveur : non livré au navigateur
Code métier et règles non observées
Données, tâches internes et infrastructure
Plusieurs implémentations peuvent expliquer la même réponse observée.
Prenons une facture. Le front peut envoyer un montant et recevoir un statut. Mais quinze règles peuvent intervenir côté serveur : habilitations, société, date, type de client, exceptions contractuelles ou validations successives. Si je n’observe qu’un seul cas, je ne connais pas les quatorze autres. Plusieurs implémentations différentes peuvent produire exactement la réponse que j’ai vue.
Il reste possible de développer une alternative à partir de spécifications, de scénarios et de tests autorisés. Simplement, l’expert métier retrouve immédiatement sa place. C’est aussi vrai pour un jeu dont les serveurs ont fermé : comprendre le client peut aider à concevoir un serveur compatible, sans recréer par magie les données historiques, l’infrastructure ni les règles jamais observées.
13 Et juridiquement, est-ce légal ?
Mon premier réflexe était d’écrire : « Bien sûr que non. » Ce serait aussi faux que d’affirmer : « L’IA l’a réécrit, donc j’ai tous les droits. » Dans le cadre européen, l’observation du fonctionnement par une personne ayant le droit d’utiliser le logiciel est encadrée. La décompilation nécessaire à l’interopérabilité bénéficie, elle aussi, d’une exception soumise à des conditions strictes ; ce n’est pas un droit général de cloner n’importe quel produit. [12]
La distinction entre fonctionnalité et expression du programme compte également. Dans l’affaire SAS Institute contre World Programming, la Cour de justice a rappelé que la fonctionnalité n’est pas, en elle-même, une forme d’expression protégée par le droit d’auteur sur le logiciel. Cela ne permet pas de reproduire librement du code, des manuels ou tous les éléments créatifs d’une application. Une réimplémentation indépendante et une copie de contenus protégés ne sont pas la même opération. [13]
Le mot « abandonware », l’ancienneté d’un jeu ou la fermeture d’un éditeur ne constituent pas, à eux seuls, une licence de réutilisation. De même, disposer d’un nouvel ensemble de fichiers sources générés par IA ne règle pas la question de leur provenance et des droits concernés. Analyser, modifier, exécuter, publier et distribuer sont des actes différents à examiner séparément. [12][14]
Je conserve donc l’émerveillement, mais je sépare les sujets. Le droit applicable dépend aussi du pays, des contrats et de l’usage envisagé ; cette section présente des repères européens, pas un avis juridique personnalisé. Il serait dommage de confondre la possibilité de sauver un logiciel avec la permission de s’approprier tout ce qui le compose.
14 Ce que cela change pour nos applications métier
Au-delà de mes jeux, je pense à tous ces logiciels conservés sur une machine virtuelle parce que personne ne sait les remplacer. Le programme de la comptable qui dépend d’un ancien Windows. L’outil industriel dont l’éditeur a disparu. Le format de fichier compris par trois personnes, dont deux sont parties à la retraite.
Dans un cadre autorisé, l’intérêt peut commencer bien avant une réécriture complète : documenter un comportement, identifier un calcul, comprendre un format, isoler une dépendance et construire des tests de référence. C’est déjà énorme. On peut aussi décider de ne moderniser qu’une partie, plutôt que demander immédiatement à l’agent de refaire tout l’univers.
Mais un logiciel métier ne se valide pas seulement parce que son écran ressemble à l’ancien. Les arrondis, les historiques, les règles de gestion et les exceptions sont parfois précisément ce qui fait sa valeur. Plus l’agent accélère la production de code, plus les exemples métier, la traçabilité et les comparaisons deviennent importants. Je ne confierais pas une clôture comptable à une jolie fenêtre simplement parce qu’elle compile.
15 La fin du software, ou une nouvelle manière de le préserver ?
En quelques années, j’ai vu mon métier se transformer avec les assistants IA, puis avec les agents de développement. Mes essais avec REA ajoutent une nouvelle pièce : je ne suis plus obligé de considérer un ancien exécutable comme un objet définitivement figé. Je peux commencer à lui poser des questions, en comprendre des morceaux et envisager une reconstruction que je n’aurais probablement pas entreprise auparavant.
Le titre est volontairement provocateur. Je ne crois pas que les logiciels disparaissent, et je ne crois pas qu’un prompt annule les droits de leurs auteurs. En revanche, je pense que notre rapport à la dépendance logicielle est en train de changer. La conservation, la réparabilité et l’interopérabilité deviennent des sujets beaucoup plus concrets lorsqu’on peut expérimenter soi-même.
Reste une question qui dépasse largement mon Raspberry Pi : comment préserver la connaissance contenue dans un logiciel tout en respectant ceux qui l’ont créée ? Dire que le savoir doit pouvoir circuler n’oblige pas à nier le travail des auteurs. Cela peut aussi nous pousser à mieux organiser les licences, la transmission des sources et la vie des produits après la fin de leur support.
En attendant d’avoir réglé toute cette question philosophique, j’ai quelque chose d’important à faire : terminer ma partie de Cluedo. Sur mon Raspberry Pi. En 16/9. Et ça, je ne l’avais franchement pas vu venir.
Sources et repères
- REA — dépôt officiel, architecture et périmètre
- REA — Native binary investigation
- Ghidra — dépôt officiel
- Model Context Protocol — Architecture overview
- OpenAI — Codex et MCP
- REA — Installation and setup
- Microsoft Learn — NTVDM and 16-bit app support
- LLVM / Clang — Cross-compilation using Clang
- REA — Website observation with CDP
- REA — Web network captures
- Open Source Initiative — The Open Source Definition
- Directive 2009/24/CE, articles 1, 4, 5, 6 et 8 — texte au Journal officiel (PDF, EN)
- CJUE — SAS Institute / World Programming, C-406/10, communiqué du 2 mai 2012 (PDF, FR)
- REA — Responsible use, résultats d’analyse et droits
- REA — Changelog officiel
Retour d’expérience personnel, complété par des sources publiques consultées le 27 octobre 2026. Les jeux et reconstructions décrits n’ont pas fait l’objet d’un audit indépendant pour cet article. Les repères juridiques portent sur le cadre européen et ne constituent pas un conseil personnalisé. Aucun exécutable de jeu, ressource protégée ou procédé de contournement n’est distribué avec cet article.
Commentaires
0 commentairesAucun commentaire publié pour le moment. Soyez le premier à réagir.