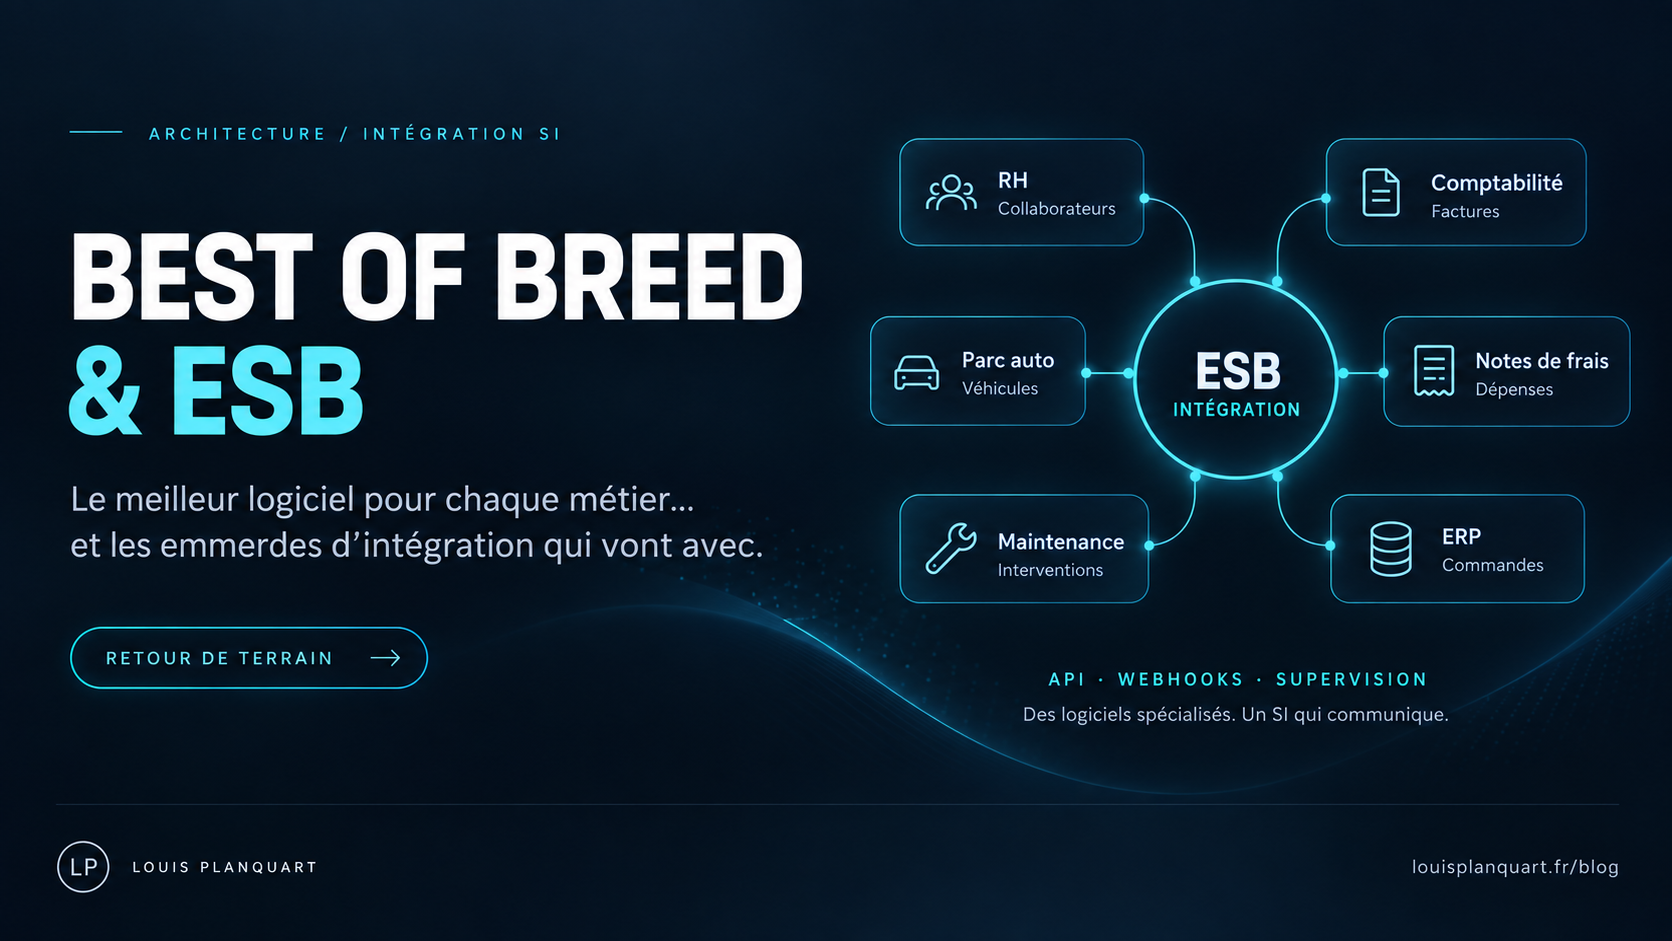
Il y a quelques années, mon client a décidé de faire évoluer profondément son système d’information. L’idée était assez simple sur le papier : arrêter progressivement de développer nos propres logiciels pour passer à une logique d’intégration de logiciels spécialisés. Autrement dit : adopter une approche Best of Breed.
Le principe du Best of Breed consiste à ne pas chercher un énorme logiciel capable de tout faire moyennement, mais plutôt à sélectionner, pour chaque métier, le logiciel qui répond le mieux au besoin. Le meilleur logiciel RH. Le meilleur logiciel de gestion de parc automobile. Le meilleur outil de notes de frais. Le meilleur logiciel comptable. Le meilleur outil de maintenance.
Le meilleur logiciel pour gérer je ne sais quel obscur processus métier que trois personnes dans l’entreprise connaissent parfaitement. Sur le papier, c’est génial. Et, à première vue, c’est même probablement l’approche idéale pour les utilisateurs. Sauf qu’il y a un petit détail.
Tous ces merveilleux logiciels vont devoir discuter ensemble.
Et c’est généralement là que les emmerdes commencent.
Chiffres de mon retour d’expérience chez ce client : le RUN ne recouvre pas les nouveaux projets ni les évolutions.
01 Le Best of Breed : formidable pour les métiers, beaucoup moins simple pour la DSI
Prenons un exemple très concret : la gestion du parc automobile. Vous avez trouvé un superbe logiciel spécialisé. Le responsable du parc l’adore. Il permet de gérer les véhicules, les cartes carburant, les contrats, les loueurs, les garages, les kilométrages et probablement la pression du pneu arrière gauche de la Clio de Michel. Très bien. Maintenant, votre responsable de parc a besoin de connaître les collaborateurs de l’entreprise.
Vous n’allez quand même pas lui demander, une fois par jour, de charger manuellement un fichier avec la liste des collaborateurs. Il a également besoin de connaître leurs absences, par exemple pour surveiller une utilisation anormale des cartes carburant pendant leurs congés. Il peut avoir besoin de données comptables. Le logiciel peut lui-même être connecté au loueur, à des garages ou à différents prestataires.
Et votre fameux « meilleur logiciel du marché » se retrouve progressivement au milieu d’une toile d’araignée. Bien sûr, il existe une autre solution. Vous pouvez recruter des petites mains qui font de la saisie au kilomètre. Ça fonctionne. Avec quelques erreurs de saisie. Des données mises à jour trois jours plus tard. Des fichiers Excel qui se promènent par mail. Des extractions manuelles. Et des gens qui commencent leur journée en important quinze CSV.
Personnellement, ça ne me fait pas rêver. D’autant que votre parc applicatif évolue en permanence. Un logiciel arrive, un autre disparaît, un troisième change d’éditeur, un quatrième décide soudainement que son API v1 est dépréciée et qu’il serait temps pour vous de passer sur la v3 avant vendredi. Bienvenue dans le Best of Breed.
02 Il faut maintenant faire parler tout ce petit monde
Une fois la vision Best of Breed posée, il fallait donc trouver une solution technique permettant de faire communiquer ces différents logiciels. C’est là que nous avons commencé à nous intéresser aux ESB. Un ESB, pour Enterprise Service Bus, est une plateforme d’intégration permettant de centraliser et d’orchestrer les échanges entre différentes applications. En version humaine :
ça récupère une donnée quelque part, ça peut la transformer, puis ça l’envoie ailleurs.
Évidemment, un ESB fait beaucoup plus que ça : orchestration, supervision, gestion des erreurs, transformations, connecteurs, appels API, traitements asynchrones, etc. Mais si vous débutez dans le domaine, retenez déjà cette phrase-là.
03 Pourquoi ne pas développer nous-mêmes ?
À cette époque, nous avions une équipe interne d’environ quatre développeurs. Techniquement, absolument rien ne nous empêchait de développer nos propres flux. Un service en .NET, Java, Python ou n’importe quelle technologie maîtrisée par l’équipe pouvait très bien récupérer les collaborateurs d’un logiciel et les envoyer vers un autre. Nous avons donc fait de la R&D.
Et, comme toute bonne équipe de développeurs lorsqu’on lui demande s’il vaut mieux acheter un logiciel ou le développer nous-mêmes, nous avons eu quelques débats particulièrement calmes et mesurés.
Évidemment.
Mais notre inquiétude principale n’était finalement pas la réalisation du flux.
Faire un flux, c’est relativement simple. Faire un flux qui fonctionne pendant dix ans, c’est autre chose. Quand le système plante, il faut des logs. Il faut savoir quelle donnée est tombée en erreur. Il faut pouvoir la rejouer. Il faut avoir des alertes. Il faut envoyer des mails ou des notifications. Il faut superviser le système. Il faut comprendre six mois plus tard pourquoi Michel avait ajouté cette condition improbable dans le code.
Et il faut surtout que tout cela continue de fonctionner lorsque Michel démissionne, change de service ou part à la retraite. Vous pouvez parfaitement développer un flux en trois jours. Puis consacrer dix ans à son MCO. Et c’est finalement là qu’une solution spécialisée commence à avoir beaucoup de sens : standardiser la manière dont les flux sont développés, supervisés et maintenus. Cette étude date maintenant d’environ quatre ans. Et je vais d’ailleurs apporter une nuance importante aujourd’hui.
Avec l’évolution extrêmement rapide des outils de développement assisté par IA et du vibe coding, je ne suis pas certain que je préconiserais automatiquement la même architecture si je devais repartir d’une feuille blanche. Avec une bonne équipe de développeurs, des agents capables d’analyser le code, de maintenir de la documentation, de générer des tests et de superviser une architecture moderne, le développement d’une plateforme d’intégration maison redevient une question intéressante. Je n’ai pas encore de réponse définitive.
Mais que vous achetiez un ESB ou que vous développiez votre propre plateforme, le besoin, lui, existe toujours. Il faut une couche d’intégration.
04 Notre choix : Phoenix de Blueway
Une fois le besoin identifié, nous avons étudié différentes solutions. Notre choix s’est finalement porté sur Phoenix de Blueway, Blueway ayant depuis été racheté par SoftProject. Plusieurs éléments nous avaient séduits à l’époque. D’abord, les capacités de réalisation des flux. Ensuite, la prise en main de la solution. Mais également quelque chose qui peut sembler secondaire et qui, avec le recul, ne l’était pas du tout : tout se faisait dans une même interface web.
Nous avions regardé d’autres solutions avec :
- un client lourd pour développer ;
- une autre interface pour la livraison ;
- un portail web pour l’exploitation ;
- encore autre chose pour l’administration.
Ça fonctionne certainement très bien dans de grosses organisations. Mais pour une équipe d’intégrateurs de moins de cinq personnes, nous avions surtout l’impression que nous allions multiplier les outils et donc la complexité. Phoenix nous semblait beaucoup plus adapté à la taille de notre équipe. Le budget avait évidemment également son importance. Parce que, contrairement à ce que certains commerciaux semblent parfois penser, nous ne disposons malheureusement pas tous d’une mine de lithium sous le bâtiment de la DSI.
05 Maintenant, il faut transformer vos développeurs en intégrateurs
Et là commence une phase particulièrement amusante. Vous allez devoir expliquer à vos développeurs que désormais ils sont des intégrateurs. Ils vont passer de leur IDE préféré à une espèce d’interface low-code. Et ils vont probablement trouver ça absolument abject. C’est normal. Ils passent d’une liberté quasiment totale à du clic-bouton. Avant :
« Je vais faire une boucle, une classe, deux fonctions, un petit objet intermédiaire et régler ça exactement comme je veux. »
Maintenant :
« Comment ça, il n’y a qu’une boucle TANT QUE dans ton machin ? »
Vous allez observer différentes phases. Le déni. La colère. La négociation. L’envie de réécrire l’ESB eux-mêmes pendant la pause déjeuner. Potentiellement quelques démissions. Mais, quelque part, cette frustration est aussi plutôt bon signe. Cela veut dire que vous avez de vrais développeurs et qu’ils aiment leur métier. La sensation qu’ils éprouvent à ce moment-là ressemble un peu à celle d’un oiseau que vous venez de mettre dans une cage.
« Mais pourquoi je n’ai plus le droit de faire ce que je veux ? »
Puis ils vont mettre leur premier flux en production. Six mois plus tard, ils vont découvrir que, s’ils n’ont pas été trop mauvais dans l’analyse et la conception, ils n’ont pratiquement rien eu à faire dessus. Et là, généralement :
« Bon… finalement, ce n’est pas si mal. »
06 Avant d’intégrer quoi que ce soit : changez vos règles
À partir du moment où nous avions adopté cette logique, nous avons également dû imposer quelques règles à l’entreprise. Si un métier souhaite acheter un nouveau logiciel, il doit évidemment consulter la DSI. Enfin… normalement. Mais surtout, nous avons décidé que la DSI devait disposer d’un véritable droit de veto technique. Parce qu’un logiciel peut être absolument exceptionnel fonctionnellement et être une catastrophe à intégrer. Un utilisateur va vous dire :
« Il est génial, il fait exactement tout ce qu’on veut. »
Puis vous allez demander :
« Il a une API ? »
Silence.
« Un export automatique ? »
Silence.
« Un webhook ? »
Encore du silence.
« Une documentation technique ? »
Le commercial regarde le plafond. Et vous comprenez progressivement que leur fameuse « intégration complète avec votre SI » consiste à déposer un fichier Excel sur un FTP chaque dimanche à 2 h du matin.
07 Oui, j’ai développé une légère obsession pour les API
Certains vous diront que les fichiers plats fonctionnent très bien. Ils auront raison. D’autres vous diront que SOAP fonctionne toujours. Ils auront également raison. Personnellement, lorsque c’est possible, je préfère travailler avec des API HTTP modernes, généralement REST/JSON ou OData selon les solutions. C’est un choix d’architecture. Et aussi probablement un caprice du technicien que je suis. Quitte à mettre en place une nouvelle intégration, j’aime autant partir sur une technologie aujourd’hui largement utilisée, documentée et facilement manipulable.
Ça ne veut absolument pas dire que REST est magique. Ça ne veut pas dire non plus qu’un fichier CSV est forcément mauvais. Et vous n’y couperez de toute manière pas. Il y aura toujours des fichiers plats. Les fichiers SEPA, par exemple. Certains échanges bancaires. Des partenaires qui n’ont rien d’autre. Des vieux systèmes dont personne n’ose toucher le serveur parce qu’on raconte qu’une fois, en 2007, quelqu’un l’a redémarré et qu’il n’est revenu que trois jours plus tard.
Mais pour des objets métier comme :
- les collaborateurs ;
- les clients ;
- les fournisseurs ;
- les devis ;
- les commandes ;
- les factures ;
si une API sérieuse est disponible, je vais naturellement privilégier cette solution.
08 Pourquoi je préfère le temps réel ou le proche temps réel
Pendant très longtemps, beaucoup d’interfaces étaient exécutées la nuit. Et ça existe évidemment encore aujourd’hui. On déclenche le traitement à 1 h. Un truc plante à 2 h 17. Si le développeur historique avait bien travaillé, une alerte est partie. Sinon, à 9 h 04, une comptable ouvre un ticket :
« Bonjour, où sont passées mes factures ? »
Et c’est parti. À l’époque, il fallait parfois également composer avec les fenêtres de sauvegarde, notamment les sauvegardes à froid des bases. Le développeur négociait alors son créneau avec l’équipe infrastructure. L’équipe infrastructure disait non. Le développeur insistait. L’équipe infrastructure disait toujours non. Et quelque part au milieu, une facture essayait désespérément de changer de logiciel. Aujourd’hui, lorsque c’est possible, je préfère largement travailler en temps réel ou proche du temps réel. Quelques secondes. Quelques minutes.
Cela présente plusieurs avantages. Les données sont fraîches. La charge est davantage répartie. Les utilisateurs disposent constamment d’informations actualisées. Et surtout, lorsqu’un problème arrive, votre équipe est probablement encore au bureau. C’est quand même plus agréable de corriger un problème à 14 h 32 qu’à 7 h du matin après avoir découvert que 60 000 lignes n’ont pas été chargées pendant la nuit.
09 Le fichier de 40 000 lignes qui tombe pour un point-virgule
Les traitements par fichiers ont également un défaut particulièrement agréable. Vous recevez 40 000 lignes. 39 999 sont parfaites. Mais Gérard a réussi à mettre un point-virgule dans une description alors que personne n’avait prévu le cas. Ou un caractère d’échappement. Ou une balise XML mal fermée. Ou un retour chariot que personne ne comprend. Et parfois :
BOUM.
Votre fichier complet est rejeté. Une architecture API traitant les événements unitairement permet généralement d’isoler beaucoup plus facilement les erreurs. Une donnée pose problème ? Cette donnée tombe en erreur. Les autres continuent leur route. Évidemment, ce n’est pas une propriété magique des API : vous pouvez parfaitement construire une API batch qui refuse 10 000 objets parce que le 8 542e est incorrect.
10 Et maintenant : bienvenue dans le monde des webhooks
Vos anciens développeurs, devenus intégrateurs plus ou moins volontairement, vont ensuite devoir apprendre un nouveau vocabulaire. Et notamment les webhooks. Un webhook permet à une application de prévenir automatiquement une autre application lorsqu’un événement se produit. Par exemple : un collaborateur est modifié dans votre logiciel RH. Plutôt que votre ESB interroge toutes les cinq minutes l’API :
« Il y a quelque chose de nouveau ? »
« Non. »
« Et maintenant ? »
« Toujours non. »
« Et maintenant ? »
le logiciel RH appelle directement une URL que vous lui avez fournie :
https://monentreprise.com/webhook
Le message peut simplement vous dire :
« Le collaborateur 123456 a été modifié. »
Votre ESB peut alors récupérer cette information, la déposer temporairement dans une file de messages ou une Data Queue, puis effectuer quelques secondes ou quelques minutes plus tard un GET sur l’API afin de récupérer les informations complètes. C’est extrêmement pratique. Et ça change beaucoup la manière de penser vos interfaces.
11 GET, POST, PUT, PATCH, DELETE… bienvenue dans les API
Votre équipe va également devoir maîtriser les principaux verbes HTTP.
| Verbe | Rôle |
|---|---|
| GET | pour récupérer une ressource. |
| POST | pour en créer une ou déclencher une action selon les API. |
| PUT | pour remplacer ou mettre à jour une ressource. |
| PATCH | pour effectuer une mise à jour partielle. |
| DELETE | … |
Bon, normalement celui-là, le nom donne déjà un indice. Puis vous allez découvrir que la théorie et la réalité des API sont deux mondes différents. Certains éditeurs ont fait les choses intelligemment. D’autres un peu moins. Pour modifier une donnée, certains vont vous imposer :
- un GET ;
- récupérer tout l’objet ;
- modifier votre champ ;
- envoyer un PATCH.
D’autres auront prévu un upsert permettant avec un seul appel de créer la ressource si elle n’existe pas ou de la mettre à jour lorsqu’elle existe déjà. Il existe des conventions. Des bonnes pratiques. Des standards. Et puis il existe ce que le développeur de l’éditeur a décidé de faire mardi matin. Vous allez apprendre à vivre avec les deux.
12 OAuth et le merveilleux monde des Bearer Tokens
Vos équipes vont ensuite découvrir OAuth. Les clients ID. Les secrets. Les scopes. Les tokens. Les refresh tokens. Les Bearer Tokens. Et parfois des documentations qui vous expliquent en cinq pages comment obtenir un token sans jamais réellement vous dire quelle URL appeler. Là encore, ça fait partie du métier. Et si vos équipes découvrent les API, équipez-les correctement.
13 Postman devient rapidement votre meilleur ami
Pour prendre en main une API, un outil spécialisé est pratiquement indispensable. Personnellement, j’utilise beaucoup Postman. Il existe évidemment des alternatives comme Insomnia, Bruno ou Hoppscotch. Mais Postman reste extrêmement pratique, notamment pendant les phases d’analyse et d’intégration. Vous pouvez organiser les appels par dossiers. Créer des environnements. Stocker vos variables. Tester rapidement un GET. Faire un POST. Modifier un payload. Comprendre pourquoi votre JSON est refusé.
Puis revenir trois semaines plus tard sur le dossier en vous demandant :
« Mais pourquoi j’ai créé six versions de cet appel ? »
Lorsque vous choisissez une solution, demandez également systématiquement la documentation API. Idéalement une spécification OpenAPI / Swagger. Et lorsqu’un éditeur est vraiment bien organisé, il vous fournira également un document permettant de faire la correspondance entre :
- le nom du champ affiché dans l’interface ;
- le nom technique dans l’API.
Ça paraît anodin. Mais lorsqu’un champ nommé « Établissement de rattachement » dans l’IHM s’appelle org_unit_ref_02 dans l’API, vous êtes particulièrement heureux d’avoir le document.
14 Acheter un logiciel en boîte signifie aussi arrêter de vouloir tout personnaliser
Il y a également une transformation importante à effectuer côté utilisateurs. Si votre stratégie d’entreprise consiste à arrêter de développer des logiciels sur mesure pour acheter des solutions du marché, il faut accepter les conséquences de cette décision. Vous achetez un logiciel en boîte. Vous n’achetez pas une équipe de développeurs dédiée à votre entreprise. Pendant l’avant-vente, certains éditeurs vont évidemment vous proposer :
« Aucun problème, ça on peut vous le personnaliser. »
Attention. Ce n’est pas forcément une bonne nouvelle. Si la solution a été conçue dès le départ pour supporter des extensions propres et maintenables, très bien. Mais si la personnalisation consiste à créer une branche spécifique du logiciel uniquement pour vous, vous êtes potentiellement en train de fabriquer votre future catastrophe industrielle. L’éditeur veut vendre. C’est normal. Au début, tout fonctionne. Puis la version suivante arrive. Et soudain votre développement spécifique n’est plus compatible.
Ou l’équipe qui l’avait développé est partie. Ou personne ne sait pourquoi cette branche existe. Et surtout, côté DSI, vous avez continué à faire croire aux utilisateurs qu’ils pouvaient conserver exactement le même niveau de sur-mesure qu’avant. Ce n’est pas cohérent. À un moment, le rôle du DSI est aussi de porter la vision :
nous avons décidé d’acheter des logiciels standards et cela signifie parfois adapter légèrement notre fonctionnement au logiciel.
Sinon, autant continuer à développer nous-mêmes.
15 Premier vrai projet : le billard à trois bandes commence
Bon. Vous avez choisi votre ESB. Vous avez choisi votre nouveau logiciel. Le projet commence. Un utilisateur vient vous voir :
« J’ai besoin d’avoir les commandes dans le logiciel. »
Facile. Bah oui. Tu prends la donnée là. Et tu la mets ici. C’est simple, non ? Alors vous ouvrez la documentation API. Première question :
Existe-t-il seulement une route permettant de créer une commande ?
Oui. Victoire. Deuxième question :
De quelles données l’utilisateur a-t-il réellement besoin ?
Le numéro de commande. Le fournisseur. Les lignes. Le montant. Le chantier. L’établissement. L’acheteur. Le contrat. La couleur préférée du responsable financier. Bref. Vous établissez la liste. Puis vous retournez dans la documentation API. Et vous découvrez que trois champs ne sont pas disponibles. Ou qu’un champ existe, mais uniquement en lecture. Ou qu’il existe dans l’IHM mais pas dans l’API. Bienvenue.
16 Et là commencent les vraies questions d’intégration
Vous allez devoir contrôler la taille des champs. Votre ERP autorise peut-être 100 caractères. Le logiciel cible en autorise 50. Très bien. Qui décide ce qu’on coupe ? Vous allez devoir charger des référentiels. Parce que votre commande référence un établissement. Et que le logiciel cible ne connaît pas encore cet établissement. Puis cet établissement référence une société. Puis cette société doit elle-même exister. Et doucement, vous découvrez une notion absolument fondamentale d’un SI intégré :
quel système est maître de quelle donnée ?
Et donc, forcément :
quel système est esclave ?
À partir de là, les schémas commencent. Parce qu’à un moment, garder l’ensemble du SI dans votre tête devient légèrement compliqué.
17 Et évidemment, les dates ne sont pas au même format
Vous ouvrez Postman. Vous tentez votre première insertion. Erreur. Vous recommencez. Erreur. Vous regardez le payload. Et vous découvrez que votre ERP vous fournit :
18/09/2026
alors que l’API attend :
2026-09-18T00:00:00Z
Très bien. Pendant votre formation ESB, personne ne vous a montré comment transformer une date. Et c’est à ce moment précis que vous commencez à comprendre que :
« Bah tu prends la donnée là et tu la mets ici. »
était peut-être une légère simplification du problème. Vous êtes dans la merde. Mais surtout : ne vous découragez pas. C’est complètement normal. Vous êtes probablement en train d’apprendre simultanément :
- un nouvel ESB ;
- un nouveau logiciel métier ;
- les API de ce logiciel ;
- parfois même un nouveau domaine fonctionnel.
Ça fait beaucoup.
18 Vos développeurs vont soudainement passer beaucoup de temps au téléphone
Vous allez également découvrir une transformation assez inattendue du métier. Avant, le développeur avait un besoin. Il développait. Maintenant, votre intégrateur passe sa journée entre :
- l’utilisateur métier ;
- le chef de projet du logiciel ;
- le développeur de l’éditeur ;
- le support de l’ESB ;
- parfois l’équipe infrastructure ;
- et lui-même, qui se demande pourquoi il n’a pas ouvert une boulangerie.
Parce que pour avancer, il doit constamment obtenir des réponses. Et c’est là que vous allez probablement découvrir qu’un AMOA devient extrêmement utile. Quelqu’un doit filtrer, clarifier et structurer le besoin utilisateur afin d’éviter que votre intégrateur passe 50 % de son temps à organiser des réunions.
19 Le flux prévu en trois jours va prendre trois semaines
Ça aussi, il faut s’y préparer. Sur le papier :
« Le flux ? Trois jours. »
Techniquement, c’était peut-être vrai. Trois jours de développement. Sauf qu’entre les trois jours de développement :
- vous attendez une réponse du métier ;
- l’éditeur doit vérifier quelque chose ;
- une route API manque ;
- l’utilisateur change légèrement son besoin ;
- il faut créer un référentiel ;
- le chef de projet est en congé ;
- quelqu’un doit ouvrir un firewall ;
- le développeur de l’éditeur n’est disponible que mardi prochain.
Très souvent, ce n’est d’ailleurs pas le développement qui pose problème. C’est une dépendance externe.
20 Entre l’avant-vente et la vraie API, il y a parfois un monde
Pendant l’avant-vente :
« T’inquiète, notre API sait tout faire. »
Trois mois plus tard :
« Alors en fait cette route-là n’est disponible que pour notre application mobile interne. »
Très bien. Vous commencez donc à fouiller la documentation avec l’éditeur. Puis vous découvrez progressivement que personne chez lui n’a vraiment utilisé certaines routes. Et vous avez parfois ce sentiment particulièrement étrange d’être le bêta-testeur de l’API d’un produit SaaS que vous payez. Vous êtes à la fois :
- client ;
- intégrateur ;
- testeur ;
- presque consultant technique de l’éditeur.
Et évidemment, à la fin du mois, la facture de licence arrive parfaitement à l’heure. Vous avez un peu l’impression d’être le dindon de la farce. C’est une sensation intéressante.
21 Après quelques années, votre manière de sélectionner un logiciel change complètement
Avec le temps, nous avons donc changé notre manière d’aborder les nouveaux projets. Aujourd’hui, dès la phase d’avant-vente, je veux savoir :
Avez-vous une API ?
Puis :
Montrez-moi la documentation.
Puis :
Est-ce l’intégralité du périmètre fonctionnel qui est disponible par API ?
Puis :
Combien de vos clients utilisent réellement cette API ?
Cette dernière question est importante. Parce qu’entre :
« Oui, nous avons une API. »
et :
« 300 clients utilisent quotidiennement notre API pour synchroniser leur SI. »
il y a une différence considérable. J’essaye également de parler le plus tôt possible avec quelqu’un de technique chez l’éditeur. Pas uniquement le commercial. Pas uniquement le chef de projet. Quelqu’un capable d’ouvrir Swagger et de parler avec l’intégrateur. Ça permet parfois d’éviter plusieurs mois de souffrance.
22 Documentez. Faites des schémas. Mappez vos champs.
C’est probablement l’un des conseils les plus importants que je puisse donner. Documentez vos flux. Faites des schémas. Identifiez clairement :
- le système maître ;
- le système cible ;
- le déclencheur ;
- les données échangées ;
- les transformations ;
- les référentiels nécessaires ;
- les routes API ;
- les erreurs possibles.
Et surtout :
mappez les champs.
Champ source. Champ cible. Type. Taille. Transformation. Valeur obligatoire. Valeur par défaut. Ça peut sembler long au début. Mais lorsque six mois plus tard quelqu’un vous demande pourquoi le code chantier est envoyé dans ContractId, vous serez heureux d’avoir votre mapping.
23 Pensez vos interfaces en demi-flux
C’est quelque chose que nous avons appris progressivement et qui devient extrêmement puissant lorsqu’un SI grossit. Évitez de réfléchir uniquement en :
Logiciel A → Logiciel B
Essayez plutôt de réfléchir en demi-flux. Par exemple :
ERP → Commande normalisée dans l’ESB
puis :
Commande normalisée → Logiciel B
Vous avez maintenant un objet « commande » propre dans votre couche d’intégration. Demain, un logiciel C arrive et a également besoin des commandes. Vous n’avez pas besoin de réécrire toute la récupération depuis l’ERP. Vous développez simplement :
Commande normalisée → Logiciel C
Puis un logiciel D arrive. Même chose. Et là, doucement, vous commencez à comprendre pourquoi l’ESB est intéressant. La donnée n’est récupérée qu’une seule fois depuis le système maître. Elle est transformée une seule fois dans un format maîtrisé. Puis elle peut prendre la route vers N applications. Vous arrêtez progressivement de faire du copier-coller de code obscur pour récupérer toujours la même information. Et votre SI commence réellement à devenir une architecture d’intégration.
24 Puis les webhooks et les files de messages commencent à accélérer tout le système
Ajoutez maintenant les webhooks. Votre ERP modifie une commande. Un événement est envoyé. Il arrive dans l’ESB. Vous le stockez éventuellement quelques secondes dans une queue. Votre flux récupère les données. Il actualise l’objet interne. Les différents systèmes abonnés sont alimentés. Quelques secondes ou quelques minutes après la modification :
la donnée est partout.
À ce moment-là, quelque chose commence à changer dans l’entreprise. Les utilisateurs arrêtent progressivement de demander :
« Quand est-ce que l’interface passe ? »
Parce que l’interface passe tout le temps.
25 Et soudain la vie devient presque agréable
Les données circulent.
La supervision est centralisée.
Lorsqu’un flux tombe, vous le voyez.
Vous pouvez intervenir pendant la journée.
Vos intégrateurs ne passent plus leur temps à maintenir 150 programmes développés dans 12 technologies différentes.
Les données sont fraîches.
Les métiers sont contents.
La comptable qui ne vous parlait plus depuis trois ans commence à vous demander comment se sont passées vos vacances.
Vous dormez mieux.
Des licornes apparaissent dans le ciel.
Vous commencez à vous demander si quelqu’un n’a pas mis quelque chose dans votre café.
Ni jamais de nouvel éditeur qui décide soudainement de changer quelque chose sans prévenir personne. Mais le RUN du système lui-même est devenu extrêmement faible par rapport au volume traité. Et finalement, c’était exactement ce que nous recherchions au début de l’aventure.
26 Alors, est-ce que je recommande le Best of Breed ?
Oui… mais pas uniquement parce que vous allez acheter de meilleurs logiciels. Le Best of Breed change beaucoup plus profondément votre système d’information. Il change votre architecture. Il change vos équipes. Il change le métier de vos développeurs. Il change la manière de sélectionner un logiciel. Il change la relation entre la DSI et les métiers. Il change votre manière de penser les données.
Et il vous oblige surtout à considérer l’intégration comme un véritable produit interne, et non comme un morceau de code qu’un développeur réalise entre deux tickets. Il faut être patient. Il faut accepter de se tromper. Il faut faire beaucoup de schémas. Il faut apprendre les API. Il faut challenger les éditeurs. Il faut documenter. Il faut superviser. Et au début, vous allez probablement avoir quelques moments où vous vous demanderez sérieusement pourquoi vous avez commencé tout ça.
Mais une fois les premières briques correctement posées, un effet d’accélération apparaît. Chaque nouveau flux bénéficie des précédents. Chaque nouvelle intégration enrichit votre patrimoine. Chaque objet métier correctement normalisé peut être réutilisé. Et progressivement, votre système d’information arrête d’être une collection de logiciels indépendants.
Il devient réellement un système.
Et finalement, c’est probablement ça le plus intéressant dans une approche Best of Breed.
Source complémentaire et périmètre du retour d’expérience
Les exemples, les choix d’architecture et les chiffres de fonctionnement présentés ici proviennent de mon expérience chez ce client. Ils ne constituent pas une promesse de performance applicable à n’importe quel SI. Le volume de 40 000 flux par jour reprend le vocabulaire de ce retour de terrain.
Blueway — annonce de son acquisition par SoftProject
Cette source documente le rapprochement entre les éditeurs ; elle n’atteste pas les chiffres de mon exploitation.
Commentaires
0 commentairesAucun commentaire publié pour le moment. Soyez le premier à réagir.