最近几天,我一直在围绕Ornith-1进行一些研发。这是我第一次觉得,一个约 350 亿参数的本地模型真正具备执行智能体任务的能力:分析项目、修改文件、执行命令、纠正错误,并分多步持续推进目标。
01Ornith-1 从何而来?
Ornith-1.0 由 DeepReinforce 团队于 2026 年 6 月发布。它并不是一个简单贴上“编程”标签的通用对话模型,而是以 Gemma 4 和 Qwen 3.5 系列模型为基础,针对智能体编程任务进行后训练的模型系列。
它的差异化来自训练方法。DeepReinforce 将这种方法称为self-scaffolding:在强化学习阶段,模型不仅学习生成解决方案,还学习改进引导解决过程的结构:搜索策略、工作记忆、错误管理和工具编排。
简单来说,Ornith 不只学习如何回答问题,也学习如何组织解决问题的过程。这正是智能体需要完成的循环:观察、行动、验证、修正并重复,直到得到结果。
智能体专用模型
该模型面向工具调用、终端操作和代码仓库任务。
MIT 许可证
模型权重采用开放许可证发布,官方未声明地域限制。
本地执行
9B 和 35B 版本提供 GGUF 格式,可通过 llama.cpp 或 Ollama 运行。
备受关注的发布
公布的性能、Ollama 兼容性和量化格式,很快吸引了本地模型用户的关注。
02为什么该模型如此受欢迎?
最先引起我注意的是 Ollama 的下载计数。模型发布约一个月后,官方页面显示下载量已超过 303,000 次。撰写本文时,Hugging Face 上七个官方仓库显示的计数合计超过 1,100 万次。
这些数字需要谨慎解读。下载次数并不等同于独立用户数,同一用户可能获取多个版本,自动化系统也会增加计数。
尽管如此,这些数据仍反映出真实关注。Ornith 出现得正是时候:许多用户需要的不只是能写单个函数的模型,而是能真正参与项目工作的模型。
- 智能体编程的明确专业化;
- 提供可本地运行的 GGUF 版本;
- 公布的上下文窗口为 256K tokens;
- 易于理解的 MIT 许可证;
- 可直接通过 Ollama 使用;
- 9B 和 35B 版本公布的成绩较高。
03Ornith-1 的不同版本
| 模型 | 架构 | 官方提供的格式 | Ollama 显示大小 | 实际使用 |
|---|---|---|---|---|
| Ornith-1.0-9B | 稠密模型,约 9B | BF16 和 GGUF | 5.6 GB | 适合本地测试、编程辅助和内存规模适中的设备。 |
| Ornith-1.0-35B | 混合专家模型(MoE),35B | BF16、FP8 和 GGUF | 21 GB | 适合较为复杂的本地智能体编程,但前提是内存足以容纳模型和上下文。 |
| Ornith-1.0-397B | 混合专家模型(MoE),397B | BF16 和 FP8 | Ollama 官方库暂未提供 | 需要多 GPU 基础设施或专用服务器,远超普通个人设备。 |
Ollama 显示的是量化模型文件大小,并非运行所需的全部内存。上下文、KV cache、缓冲区和智能体工具都会显著增加内存占用。
04模型发布方公布的结果
以下成绩由 DeepReinforce 公布,可用于了解模型系列的定位,但不能替代独立评测。这些基准还使用了较大的上下文和特定智能体环境。
| 模型 | Terminal-Bench 2.1 | SWE-bench 已验证 | SWE-bench Pro | NL2Repo |
|---|---|---|---|---|
| Ornith-1.0-9B | 43.1 | 69.4 | 42.9 | 27.2 |
| Ornith-1.0-35B | 64.2 | 75.6 | 50.4 | 34.6 |
| Ornith-1.0-397B | 77.5 | 82.4 | 62.2 | 48.2 |
35B 版本尤其值得关注。按照发布方数据,它在 Terminal-Bench 2.1 上得到 64.2 分,而 Qwen 3.6-35B 为 52.5 分;在 SWE-bench Verified 上差距较小,为 75.6 对 73.4。这支持一个重要判断:Ornith 的优化目标更偏向完整智能体任务,而不只是代码生成。
05我的测试环境
家用 AI 主机
两张 12 GB NVIDIA RTX 3060,合计 24 GB VRAM;GPU 放不下的部分会溢出到系统内存。
MacBook Pro M4
CPU 与 GPU 共享 32 GB 统一内存。模型和上下文可以使用同一内存空间,但余量不大。
云端对比
通过我的 Pro 订阅使用 Codex 与 GPT-5.6 SOL,模型运行在我无法控制硬件的远程基础设施上。
我的编程测试使用了至少 64K tokens 的上下文。这一点非常关键:Ollama 本身也建议编程智能体至少使用 64K。上下文越长,内存占用越高。
Ollama 分发的 Ornith 35B 模型文件约为 21 GB。因此,两张 RTX 3060 的 VRAM 无法轻松容纳模型、上下文、KV cache 和缓冲区,部分负载会经 PCIe 转移到系统 RAM 和 CPU。
ollama run ornith:35b

OLLAMA_CONTEXT_LENGTH=64000 ollama serve

ollama ps

ollama launch codex06测试 1:创建 Flappy Bird
第一个测试很经典:让模型创建一个 Flappy Bird 游戏。规则很简单,小鸟自动前进,玩家控制它上升并避开管道。
这类项目在公开数据、教程和 GitHub 示例中非常常见。更重要的是,它能快速检验智能体是否会创建多个文件、选择技术方案、运行程序并修正错误。
07测试 2:在两张 RTX 3060 上开发 C 语言计算器
第二个测试我刻意选择了不那么常规的任务:使用 C 语言开发一个具有真实图形界面的计算器,视觉风格参考 Windows 3.1。
我不想让它借助现代库,用几行 Python 完成计算器,而是希望把模型推入更严格的环境:窗口管理、按钮、事件、原生编译以及 macOS 适配。
此时,硬件限制开始显现。量化模型、64K 上下文和智能体运行数据已无法完全放入 24 GB VRAM,Ollama 与 llama.cpp 只能在两张 GPU 和系统内存之间分配负载。
简单来说,模型把一部分时间花在传输数据而不是计算上,显卡无法保持最佳工作状态,生成速度随之大幅下降。
08在 MacBook Pro M4 上进行相同测试
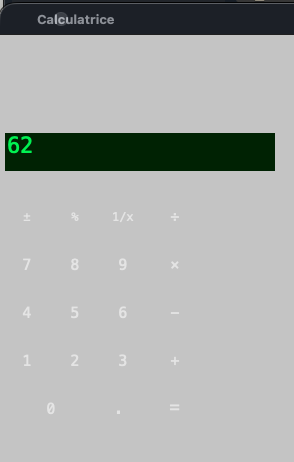
我又在配备 32 GB 统一内存的 MacBook Pro M4 上执行了相同任务,并关闭其他应用,为 Ollama 尽可能腾出内存。
Mac 在 GPU 满负载状态下运行了约 35 分钟。第一个结果确实显示了类似计算器的界面,但按钮无法正常工作。
我向模型说明问题。大约十分钟后,模型修改项目并重新编译,最终在 macOS 上得到可用的 C 语言计算器。
优势并不只来自多出的 8 GB。Apple 统一内存让 CPU 与 GPU 使用同一内存空间,从而减少系统 RAM 与多张独立显卡之间的数据传输。
09Codex、Ollama 与智能体模式
我使用了两种方法来检查编排工具是否确实改变了结果。
第一种是启动 Codex,并将 Ollama 作为本地模型提供方。Ollama 现在提供 ollama launch codex 命令,该命令将 Codex 配置为使用本地或远程模型。
第二种是使用由 Ollama 启动的命令行智能体。它具备真正的工具调用能力,可以读取和修改文件、执行命令并持续推进任务。因此,我这里讨论的不是通过ollama run得到的普通聊天会话。
在我的配置中,第二种方法效果最好。它似乎更好地遵循了模型的原生参数,也更善于处理长会话。Codex 连接 Ollama API 同样可用,但在我的测试中对可用上下文的利用率较低。
10与 GPT-5.6 SOL 对比
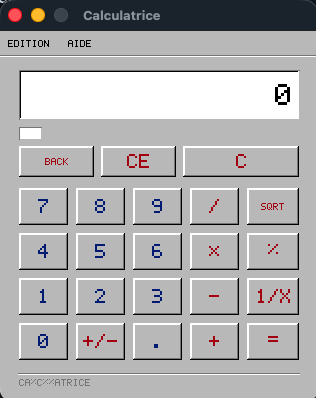
然后,我要求 Codex(使用我的 Pro 订阅)和 GPT-5.6 SOL 用 C 创建相同的计算器。
不出所料,首个结果更快出现,完成度看起来也更高。有趣的是,模型遇到了相同问题:界面能够显示,但按钮无法正确点击。
不过,云端模型的诊断更准确。它发现问题来自 Mac Retina 显示屏的缩放与坐标处理,并在第二轮完成修正。
| 配置 | 实测耗时 | 结果 | 分析 |
|---|---|---|---|
| Ornith-1 35B · 2 × RTX 3060 12 GB | 一个多小时 | 失败 | 模型和上下文太接近内存限制,大量卸载到 RAM 和 CPU。 |
| Ornith-1 35B · MacBook Pro M4 32 GB | 约 45 分钟 | 经过两轮完成 | 统一内存让任务得以完成,但余量不大,GPU 基本满载。 |
| GPT-5.6 SOL · Codex Pro | 约 10 分钟 | 经过两轮完成 | 更快、诊断更准确,但依赖更强大的云基础设施。 |
从科学角度看,这并不是公平的对比,因为模型、基础设施、量化方式和编排工具都不同。但它反映了用户使用现有手段实际能够得到的结果。
11此测试实际显示了什么
这个测试看似有些刻意,但有趣之处也正在这里。如果我要求使用常见图形库编写 Python 计算器,Ornith 很可能十分钟左右就能完成。
我的目标是离开最常见的实现路径,让模型面对更棘手的组合:C 语言、复古 GUI、macOS 原生编译、事件处理和 Retina 缩放。
- 35B 模型现在可以执行真正的本地智能体任务;
- 可用内存通常比理论参数数量更具决定性;
- 64K 上下文完全改变了硬件要求;
- 智能体工具及其集成几乎与模型一样重要;
- 本地仍然比领先的云模型慢得多;
- 本地模型的进展速度足够快,足以涵盖新的用途。
即使在六个月前,我也很难想象这种规模的本地模型可以如此顺利地完成这类任务。模型规模仍然重要,但训练、编排和专业化正在让较小硬件实现更多能力。
12对企业有何影响?
问题不再只是“市场上哪个模型最好”,而是每种用途需要怎样的算力、隐私水平和成本。
| 使用 | 现实的解决方案 | 主要优势 | 主要限制 |
|---|---|---|---|
| 电子邮件重写、简短摘要、分类 | 小型本地模型,例如 Gemma、Qwen 或 Mistral | 数据保存在本地且边际成本低 | 处理复杂任务时推理能力有限 |
| 处理文档和 RAG 的内部助手 | OpenWebUI 配合 9B 至 35B 的本地模型 | 数据、账户与内部资源保持可控 | 需要维护基础设施和运行环境 |
| 在真实代码仓库中进行智能体编程 | Ornith-1 35B,上下文为 64K 或更多 | 代码与知识产权保留在本地 | 内存要求高,速度比云低 |
| 长时间任务或高级推理 | 高端云模型或配备大容量统一内存的设备 | 更好的质量和速度 | 成本、供应商依赖性和数据治理 |
DGX Spark 或同类设备配备 128 GB 统一系统内存。这并不等同于传统意义上的 128 GB 独立 VRAM,但该架构提供了足够空间,可在本地运行无法轻松装入 24 GB 显卡的模型与上下文。
还有一些折中方案。企业可以选择法国的 Mistral(其 Le Chat 现已更名为 Vibe)、采用欧洲服务,或在自有基础设施上部署部分模型;只有在数据外发风险与成本确有合理回报时,才调用能力最强的美国或中国模型。
因此,企业不应再把 AI 简化为“给所有员工购买同一种许可证”。更合理的做法是试验、测量,并定义自己的服务等级。
为此,没有必要在 LinkedIn 上寻找那些使用夸张头衔、把自己包装成新兴技术绝对专家的人。真正有效的方法仍然是动手实验、测试、发现问题、测量并重新开始。
S来源与说明
- DeepReinforce — Ornith-1 的官方 GitHub 仓库
- DeepReinforce — self-scaffolding 方法和基准的介绍
- Hugging Face — DeepReinforce 发布的官方模型与版本
- Ollama — Ornith 官方模型库、文件大小与下载量
- Ollama — 上下文长度与内存占用说明
- Ollama — 与 Codex 的官方集成说明
- Ollama —
ollama launch命令介绍 - NVIDIA — DGX Spark 官方规格
- Mistral — 公司介绍与部署方案
下载量、版本可用性与运行时性能都可能快速变化。文中数值以撰写时公开可见的信息为准。

评论
0 条评论暂无已发布评论,欢迎率先参与。